Részletes bemutató
A Legacy Explorer egésze hat percen belül: a kód, a folyamatok és az adatbázis térképe, a kapcsolatok, a hatáselemzés és a tudásbázis.
Átirat
A Nitro Legacy Explorer a kódból építi fel annak a rendszernek a dokumentációját, amiről nincs használható leírás. Kétféle rendszert térképez fel. Az egyik az alkalmazáskód, a benne futó folyamatokkal.
A másik az adatbázis, ahol kód nincs, csak séma. Egy vezető közép-európai bankcsoport back-office-a: nagyjából ötszázhetven üzleti folyamat, ötszáz Java delegate, ötszázötven tábla, negyvenöt kapcsolódó külső rendszer. Egyetlen fejben ez már nem fér el.
A tudás fejekben és ticketekben él, a fejlesztőcsapat a saját folyamatrétegét is túl szövevényesnek nevezi, a leírt dokumentáció pedig elavul, mire elkészül. Közben két futtatókörnyezet fut egymás mellett, egy húszéves monolit és egy tízéves modernizált platform, a workflow-motor pedig az életciklusa végén jár. Kézzel ez körülbelül hat hónapos munka, és mire elkészül, már nem igaz.
Erre ma háromféle válasz létezik. A nagyító: fejlesztői kódgráf-eszközök, amik a kód nyelvtanából építenek determinisztikus gráfot. Arra jók, hogy mi hív mit.
A lexikon: általános kódelemző platformok, amik az egészet egy közös keresőrétegbe olvassák. Azonnal működnek mindenre, de mindenütt ugyanabban a közepes mélységben. A harmadik a térkép, és mi ezt csináljuk: célzott, rétegezett elemzés, ami arra válaszol, hogy üzletileg mit csinál a rendszered.
Ehhez fordított sorrendben dolgozunk. Először egy determinisztikus szkennelés olvassa végig a forrást: hívási gráfok, függőségi élek, interfész-leltár, ujjlenyomatok. Amit egy értelmező ki tud olvasni, azt nem bízzuk modellre.
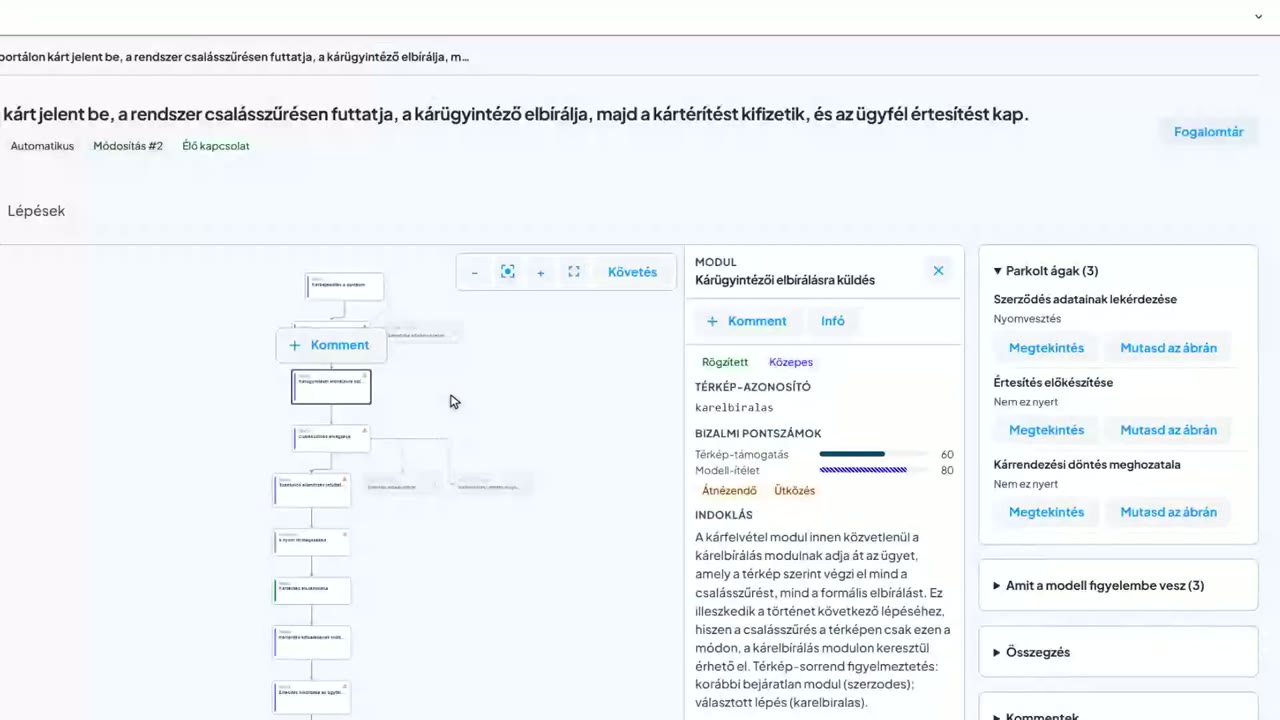
A modell csak ezután jön, és nem keres, hanem értelmez: modulonként, függőségi sorrendben, mindig csak a releváns kontextussal. Ez az eredménye: a rendszer modulokra bontva, a köztük futó hívásokkal. Ez a kép azt mondja el, hogy összetett rendszert is fel tudunk mérni.
Ha viszont egyetlen részre vagy kíváncsi, elég rákattintani. Az első adatforrás maga a kód. Minden modulhoz elkészül egy olvasható profil, ami arra válaszol, amit egy új kolléga vagy egy üzleti elemző kérdezne: mit csinál ez a rész, kinek dolgozik, milyen képességei vannak.
Mellette az architektúra megmutatja a határokat, a kódbázis pedig a méretet, fájlban és sorban, szerepek szerinti bontásban. A komplexitás azt mutatja meg, hol koncentrálódik a bonyolultság, tehát hol drága hozzányúlni, és mi az, amit érdemes kétszer meggondolni egy migráció előtt. Ezek nem becslések, hanem a kódból számolt értékek.
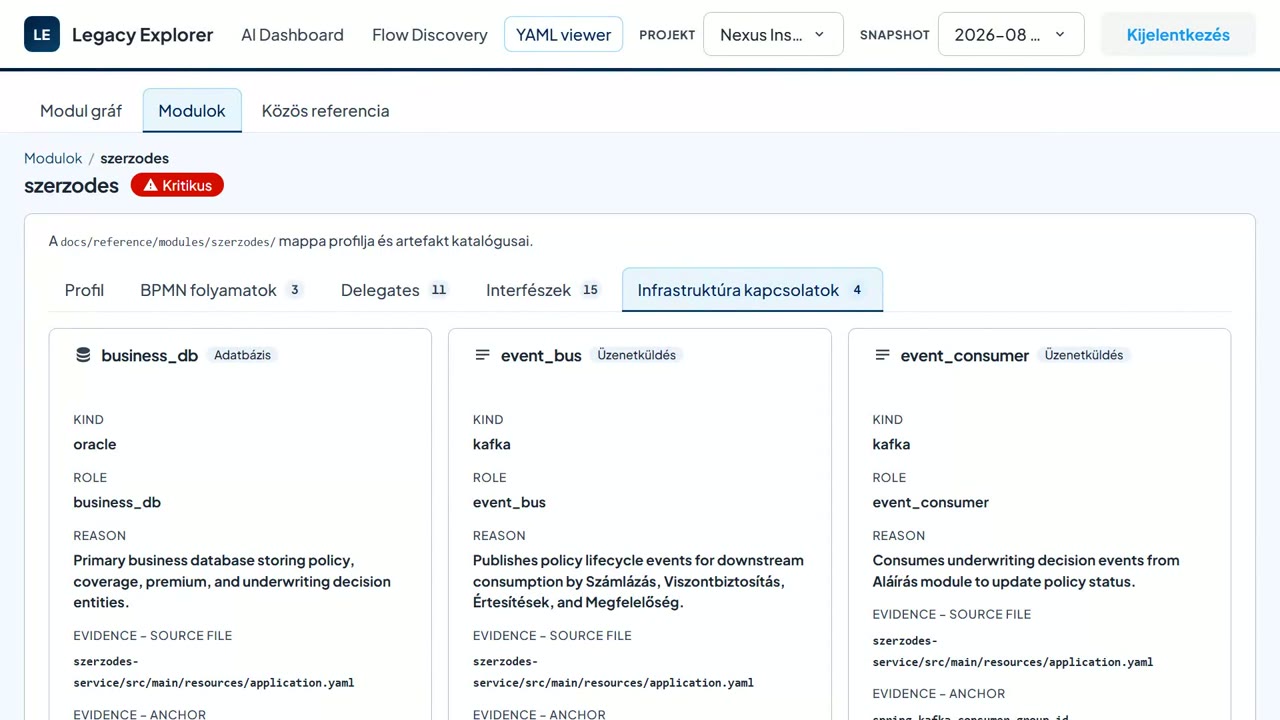
A második adatforrás a folyamat. Ahol Camunda fut, ott a folyamatleírók is bekerülnek az elemzésbe, és a rendszer lépésenként végigköveti, melyik feladat melyik kódrészletet hívja meg. Ezek a delegate-ek, és mindegyik mögött ott a forrásfájl, amiből kiolvastuk: egy valódi Java-útvonal a kódbázisból.
Nem kell elhinni, vissza lehet ellenőrizni. Az is kiderül, mi az, ami papíron létezik, de a gyakorlatban már senki nem indítja el. Ugyanez a folyamat lerajzolva is megnézhető.
Balra az annotált ábra: színezve látszik a happy path, a hibaág, és az is, hol történik commit. Jobbra a generált üzleti nézet: mit csinál a folyamat, mi indítja, mi a kimenete, és milyen fogalmakhoz kapcsolódik. A kettő ugyanabból az elemzésből származik, tehát az ábra és a leírás nem tud elcsúszni egymástól.
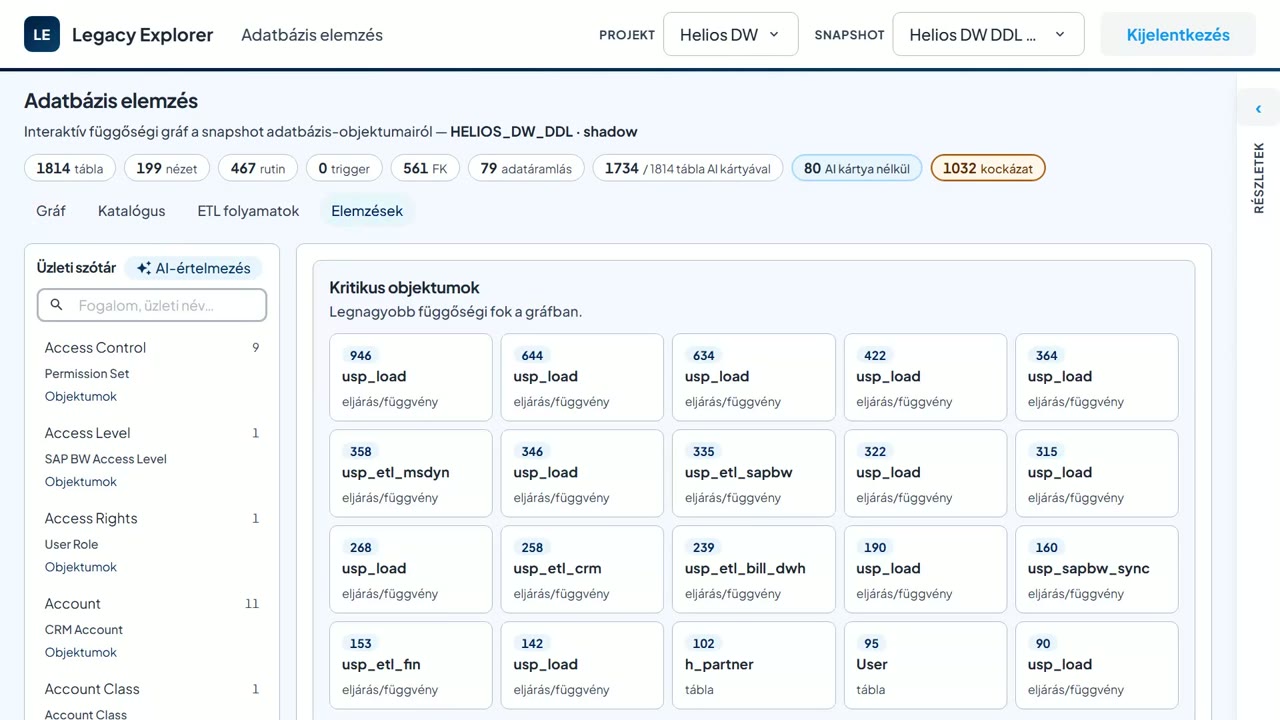
És ez nem egyetlen szerencsés eset: a következő példa egy másik folyamat, ugyanezzel a bontással. A harmadik adatforrás az adatbázis, és ez a legnehezebb eset, mert itt nincs kód, csak séma. Ez a példa közel kétezer táblát és több száz tárolt eljárást tartalmaz, kommentek nélkül.
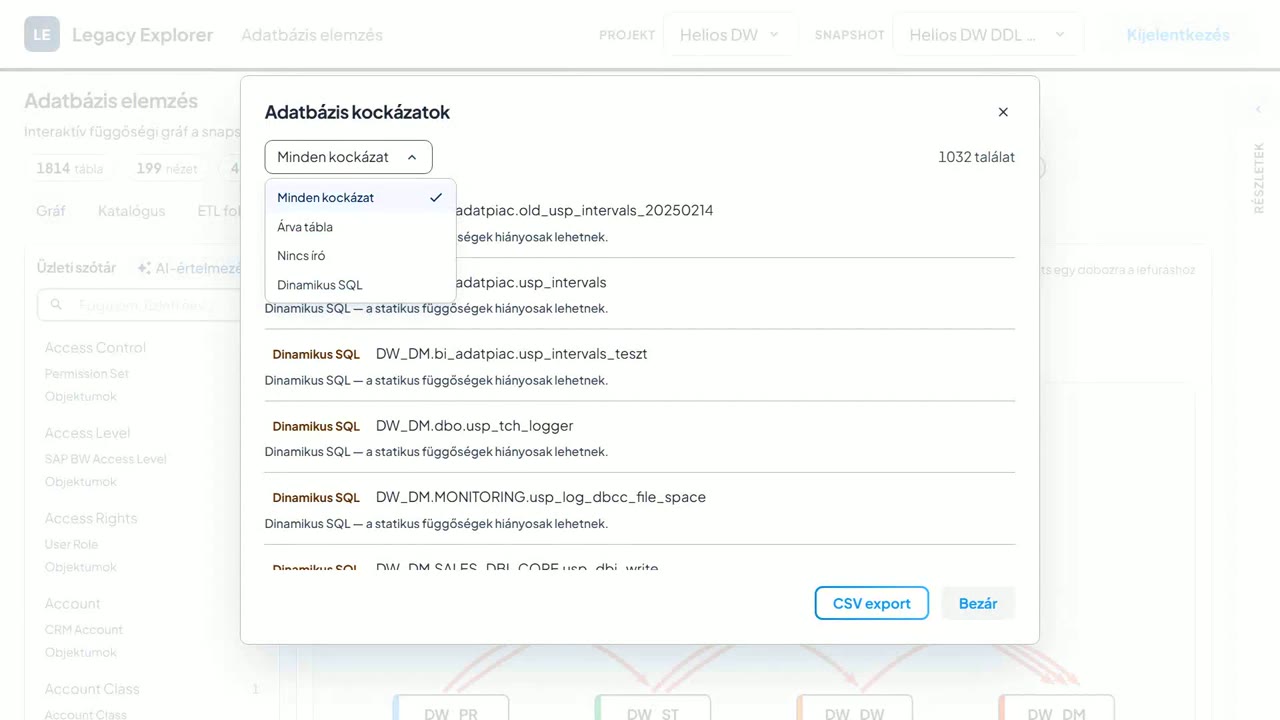
A rendszer ebből is fel tudja építeni, mi mihez kapcsolódik, mert kiolvassa a definíciókból. És nem csak azt mondja meg, mit talált, hanem azt is, mit nem: itt ezerhétszázharmincnégy objektumhoz készült értelmezés, nyolcvanhoz nem. A hiányzókat fontossági sorrendbe rendezi.
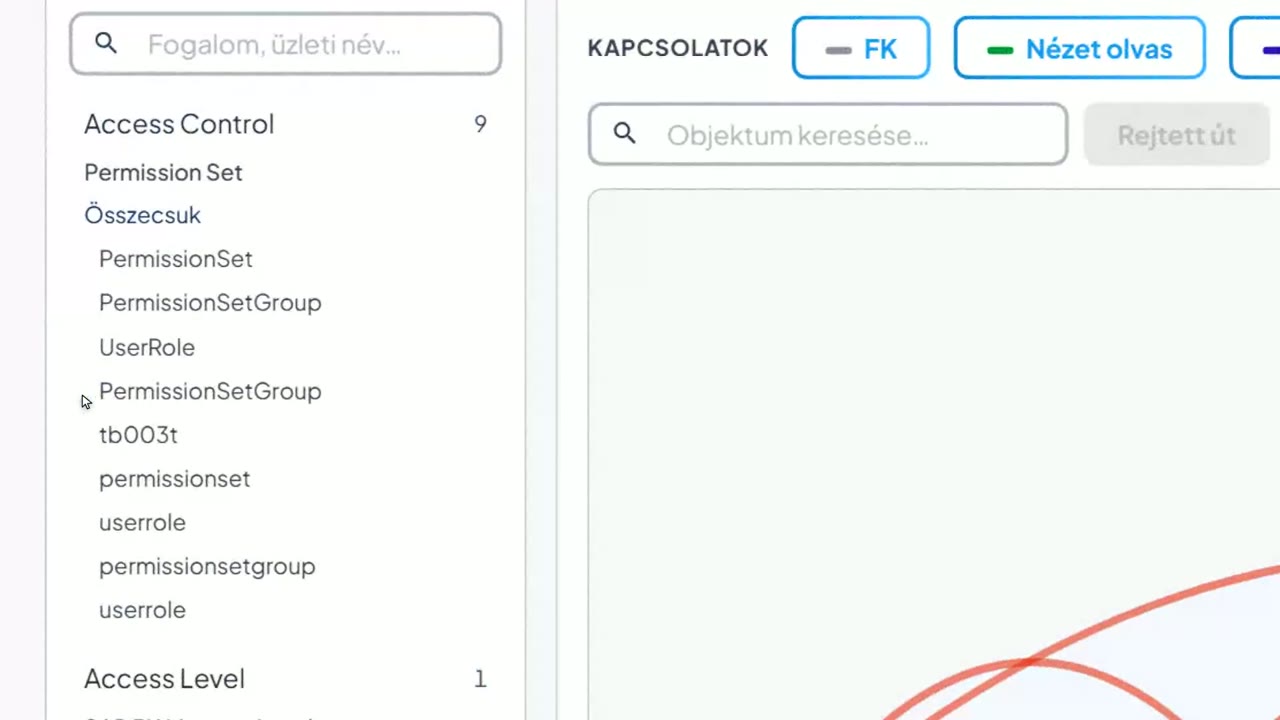
Ez a lista a kérdés, amit a rendszer feltesz nektek. Ami a három forrásból összeáll, az nem lista, hanem kapcsolati háló. Minden modulnál látszik, honnan érkezik hozzá hívás és hová megy tovább, milyen interfészen, és mi a hívás célja.
Ebből jön a válasz a leggyakoribb kérdésre: mi történik, ha hozzányúlunk. Megadható egy kiinduló objektum és egy célpont, a rendszer pedig megkeresi, vezet-e út közöttük, és milyen rétegeken keresztül. Ez az a munka, amire ma egy fejlesztőnek egy vagy két hetet kell adni.
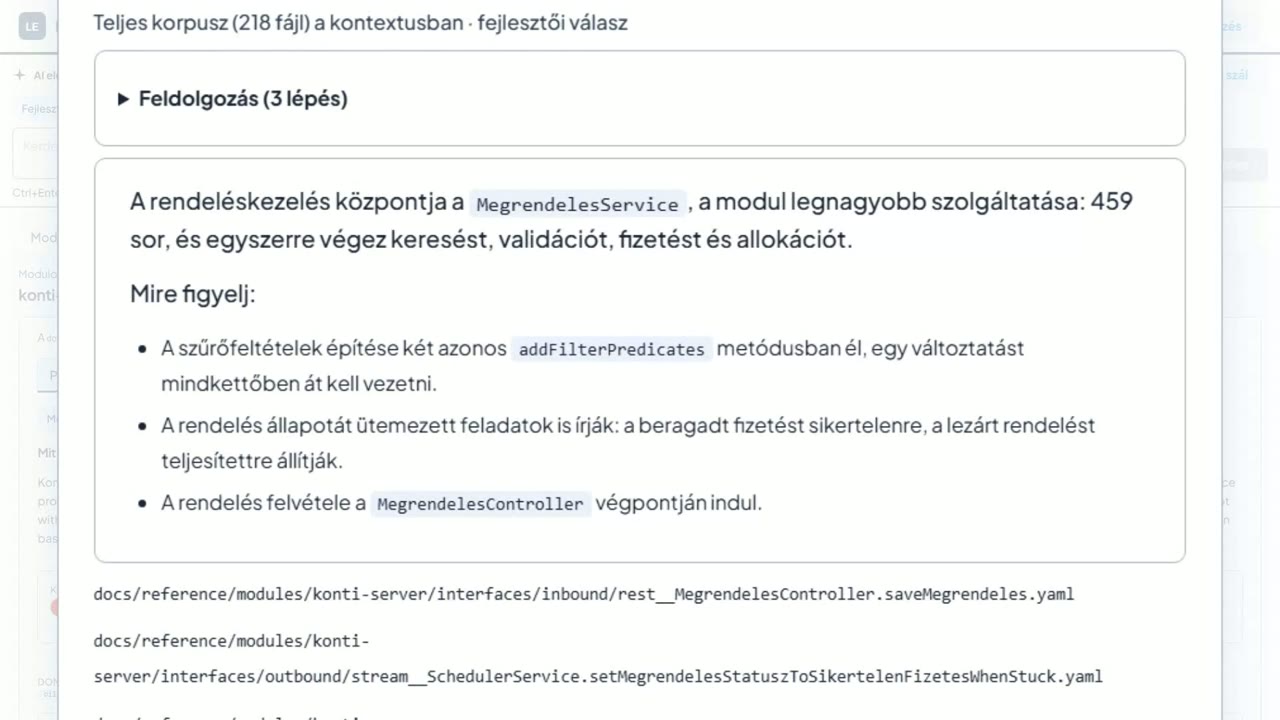
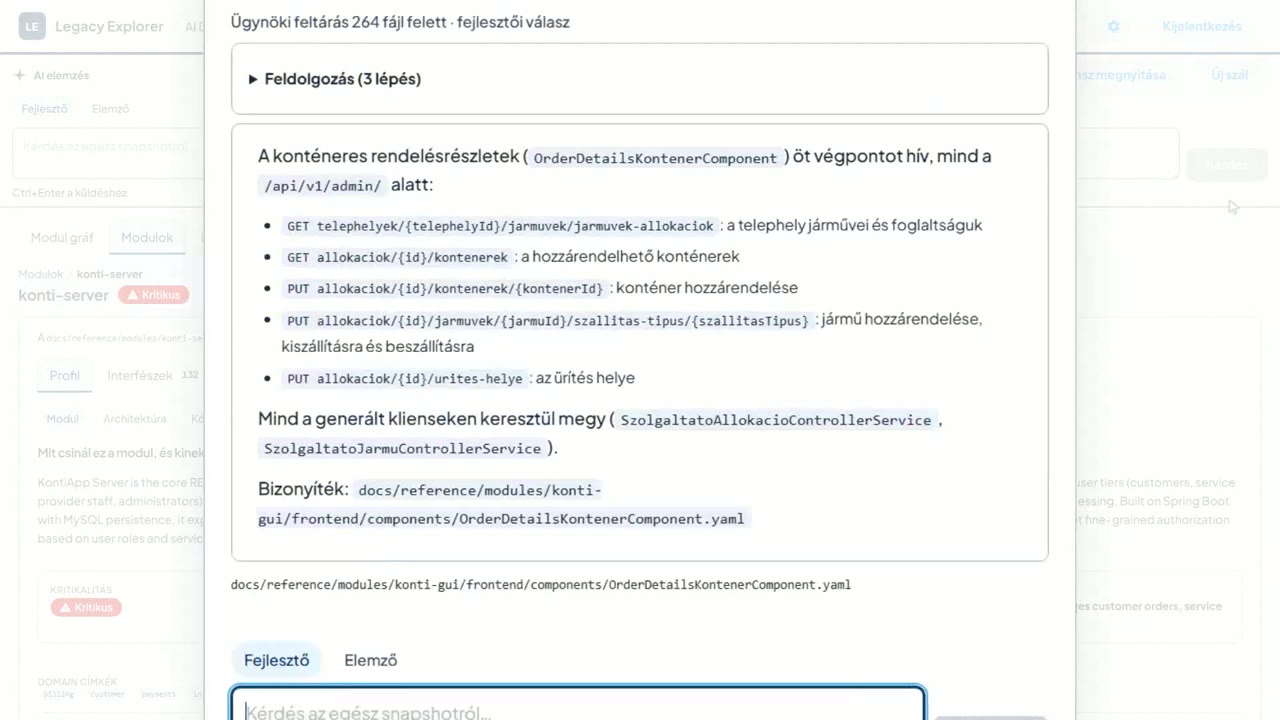
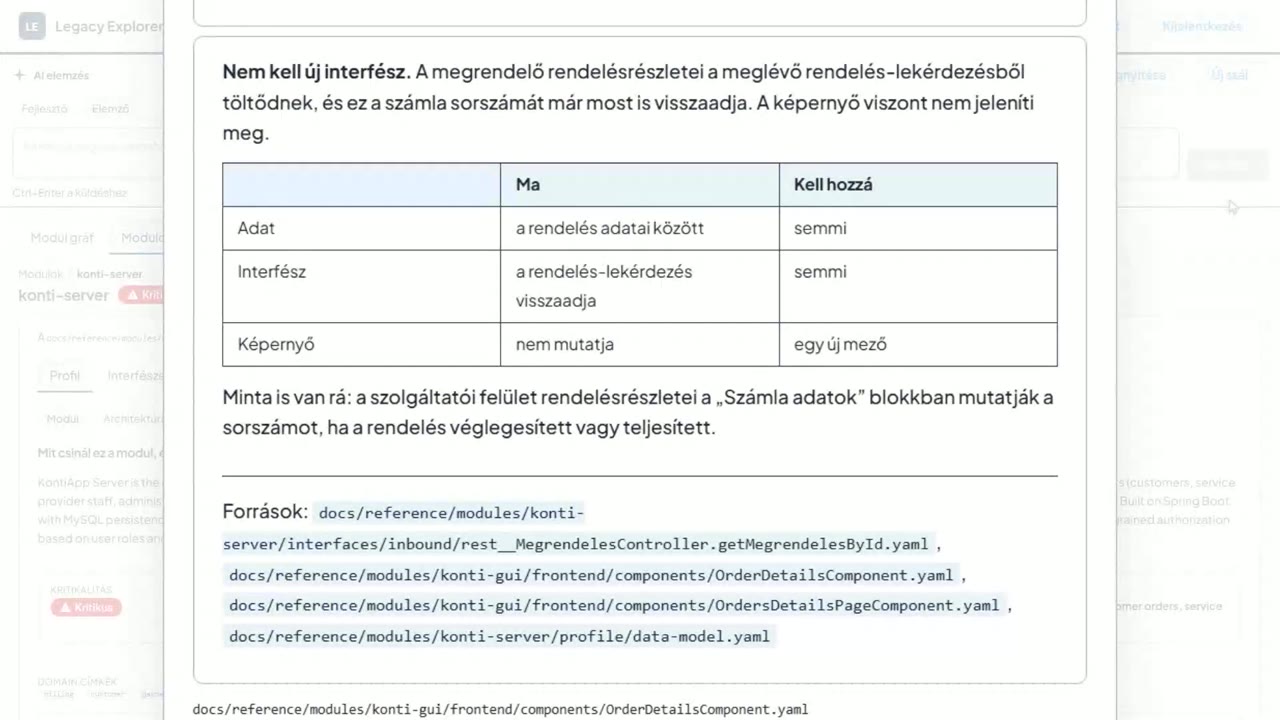
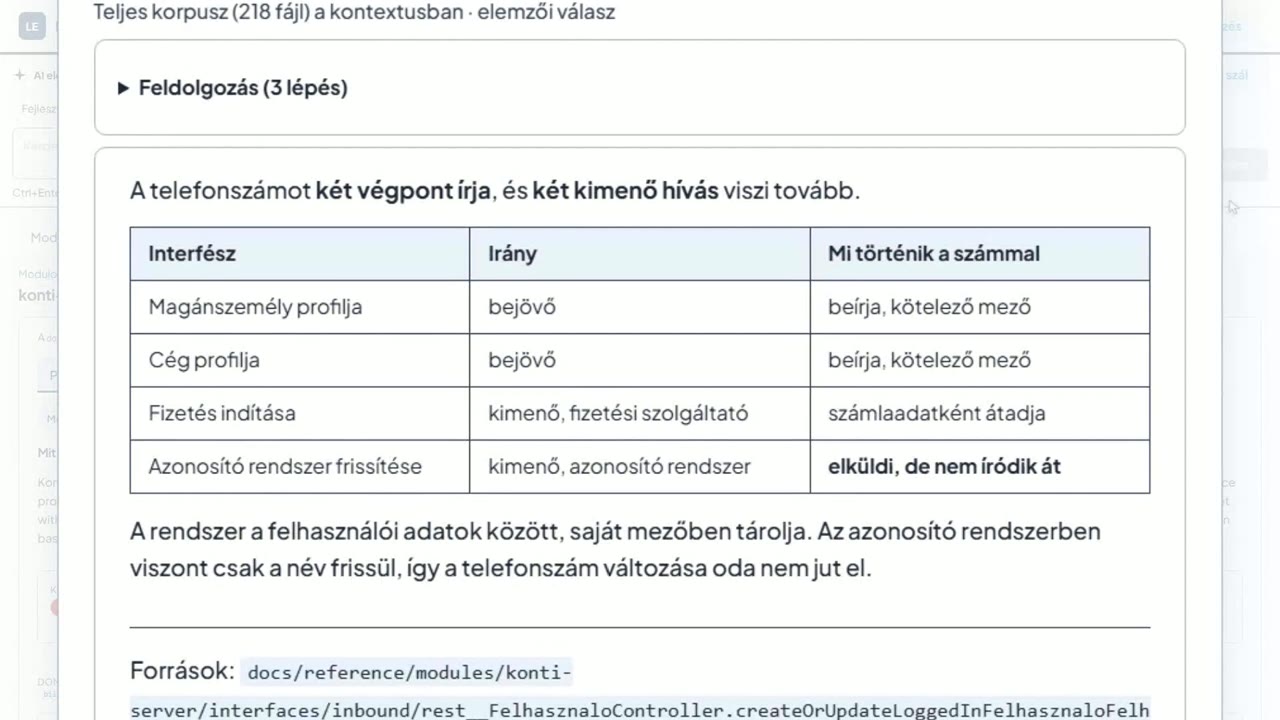
A kimenet nem csak ez a felület. Az elemzés eredménye egy lekérdezhető tudásbázis, amit a saját eszközöd kérdez: üzleti fogalmakra, folyamatokra, delegate-ekre, hatáselemzésre. Ugyanaz a tudás érhető el a fejlesztő szerkesztőjéből, az elemző chat-felületéről, sőt egy vállalati tudásbázis mögé kötve is.
Nem oda kell menni a válaszért, ahol a dokumentáció van, hanem ott van, ahol dolgozol. Kérdezni emberi nyelven is lehet. A rendszer az elemzett adatokból rajzol: melyik modulok függenek egymástól, hol vannak a feloldatlan hivatkozások, mi a teljes katalógus.
A kérdések elmenthetők, tehát amit egyszer megfogalmaztál, azt legközelebb nem kell újra megfogalmaznod. Ez nem külön termék és nem külön adat, hanem ugyanaz a térkép, másik nézőpontból. A térkép kiolvasott kapcsolatokból épül fel, nem találgatásból, és minden állítás mögött ott a forrásfájl.
Nem egyszeri jelentés: minden változás után újratermelhető, és mindig az aktuális állapotot írja le. Az elemzés futhat a saját környezetetekben, és a forráskód nem kerül ki.